陳致生 | Chih-Sheng Chen機器學習、數學與訊號處理筆記 (舊名「棒棒生」)

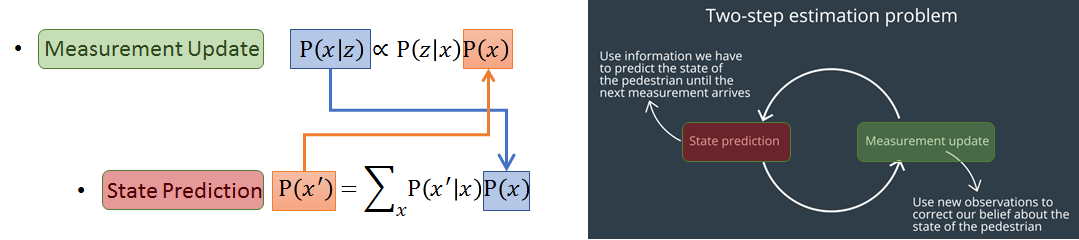
統一的框架 Bayes Filter


Bayes Filter Introduction

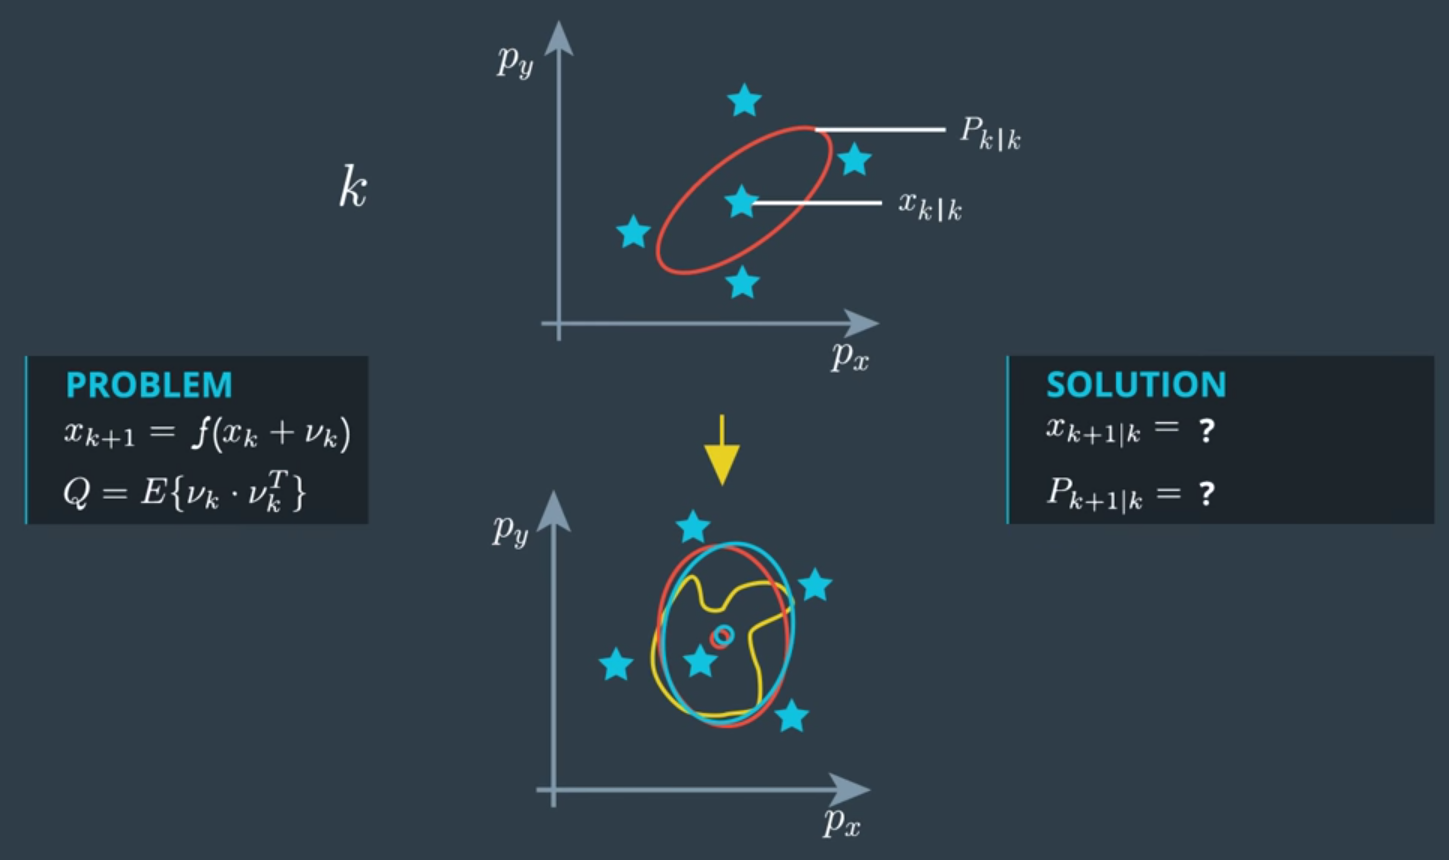
前幾篇討論了很多 Kalman Filter 以及它相關的變形,如: EKF and UKF。這些方法我們都可以放在 Bayes Filter 的框架下來看,這麼做的話,KF 就只是其中一個特例了 (都是高斯分布的情形)。而如果我們只考慮幾個離散點的機率,並用蒙地卡羅法來模擬取樣的話,這種實作方式就會是 Particle Filter 。所以掌握了 Bayes Filter 背後的運作方式對於理解這些方法是很有幫助的。
一些變數的意義仍然跟前幾篇一樣:

  • z: measurement,也就是我們實際上經由 sensor 得到的測量值 (會有noise)
  • x: state,我們希望估計出來的值,在 Localization 一般就是座標值
Notes for Unscented Kalman Filter


資料為 Udacity 課程內容。事實上 UKF 挺囉嗦的,單純看本文應該無法理解,必須搭配前兩篇 KF and EKF 和 CTRV。主要是筆記用,讓自己可以根據文章完整實做出來。

一切的一切都來自於 Kalman Filter 的 State-Space model 假設,我們來稍微回顧一下。

$$\begin{align} x_k = F_kx_{k-1}+\nu_k \\ z_k = H_kx_k+\omega_k \\ \end{align}$$

CTRV Motion Model


Motion Models

資料為 Udacity 課程內容

在上一篇 EKF 中,我們其實假設的是 constant velocity model (CV),也就是如下的關係式
$$\begin{align} x_k = Fx_{k-1}+\nu_k \\ x_k= \left( \begin{array}{clr} p_x \\ p_y \\ v_x \\ v_y \end{array} \right), F= \left( \begin{array}{clr} 1 & 0 & \Delta{t} & 0 \\ 0 & 1 & 0 & \Delta{t} \\ 0 & 0 & 1 & 0 \\ 0 & 0 & 0 & 1 \end{array} \right) \end{align}$$ 正好滿足 Kalman Filter 中 State-space model 的假設,但這樣的 motion model 很明顯太單純了,因為車子總是在變速且轉彎。因此真實在使用的時候不會用 CV model,那會用什麼呢? 以下為幾種可用的:

Notes for Kalman Filter and Extended KF


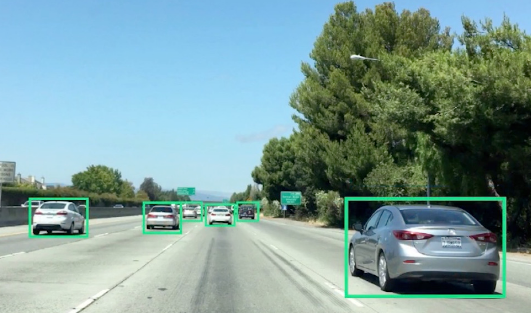
Udacity term2 (Sensor Fusion, Localization, and Control) 的第一個 Project 就是用 KF and EKF 將 Lidar and Radar 的資訊做 fusion 並且可以 tracking。由於 KF/EKF 的數學符號很多,因此想筆記一下方便日後回想,所以主要以我自己看的角度,可能有些地方會沒有明確說明。本篇的筆記來源是

  1. 這裡,這篇真的講的超棒的,清楚易懂! 非常建議直接去看!
  2. Udacity 課程內容

若要實作所有的計算流程不管理論的話,可直接跳到 “7. 總結 Lidar and Radar Fusion”。

WGAN Part 2: 主角 W 登場


前情提要

GAN 作者設計出一個 Minimax game,讓兩個 players: 生成器 G 和 鑑別器 D 去彼此競爭,並且達到平衡點時,此問題達到最佳解且生成器 G 鍊成。大致上訓練流程為先 optimize 鑑別器 D for some iterations,然後換 optimize 生成器 G (在 optimize G 時,此問題等價於最佳化 JSD 距離),重複上述 loop 直到達到最佳解。
但是仔細看看原來的最佳化問題之設計,我們知道在最佳化 G 的時候,等價於最佳化一個 JSD 距離,而 JSD 在遇到真實資料的時會很悲劇。
怎麼悲劇呢? 原因是真實資料都存在 local manifold 中,造成 training data 的 p.d.f. 和 生成器的 p.d.f. 彼此之間無交集 (或交集的測度為0),在這種狀況 JSD = log2 (constant) almost every where。也因此造成 gradients = 0。
這是 GAN 很難訓練的一個主因。

也因此 WGAN 的主要治本方式就是換掉 JSD,改用 Wasserstein (Earth-Mover) distance,而修改過後的演算法也是簡單得驚人!

WGAN Part 1: 先用 GAN 鋪梗

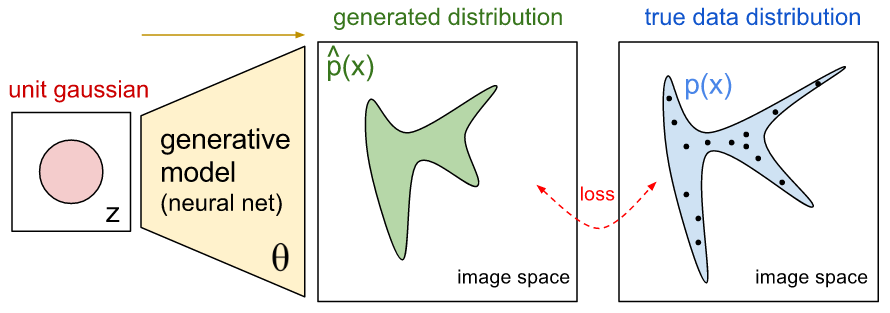
Open.ai 這張表達 generative modeling 的意思很清楚,忍不住就借用了。

筆者才疏學淺,如有錯誤,還請指正

Generative Adversarial Nets 提出了一個 NN 的 generative modeling 方法,在這之前,NN 要成為 p.d.f. 必須依賴於 sigmoid activation 的 Restricted Boltzmann Machines (RBM) 結構。例如 Deep Belief Net,整個 network 才會是一個 p.d.f.。然而學習這樣的一個 p.d.f. 必須使用 Contrastive Divergence 的 MCMC 方法, model 訓練完後要產生 sample 時也還是必須依賴 MCMC。加上在實用上,偏偏 sigmoid 很多時候效果不如 ReLu, maxout 等,例如 sigmoid 有嚴重的 gradient vanish problem。這使得 NN 在 generative modeling 又或是 unsupervised learning 上一直困難重重。

GAN 一出立即打破這個難堪的限制 ! 怎麼說呢? GAN 捨棄能夠明確表達出 p.d.f.的作法,寫不出明確的 p.d.f. 一點也沒關係,只要能生成 夠真的sample點,並且sample的機率跟training data一樣就好

Why-Aggregation-Work

為何三個臭皮匠會勝過一個諸葛亮?


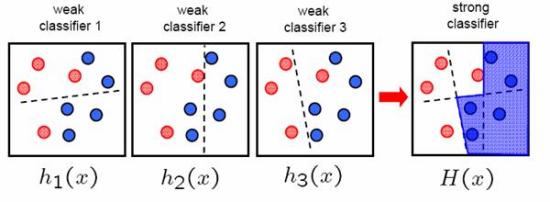
在 ML 中有一類的演算法稱為 Aggregation Methods,這方法的運作方式其實我們可能從小就接觸到了。有沒有遇過一種情況就是,當一群人遇到一個不知道最好答案的時候,最直接的方式就是大家的答案取平均。
聽起來很直覺,但心裡老覺得怪怪的,因為根本不知道到底可不可靠。
Aggregation methods 就是這樣的運作模式,這邊就給個結論,它很可靠!

Neural Art

Art with Neural Network


風格, 創作這種能力在現在Alpha Go已經稱霸的時代, 目前覺得還是人類獨有的
不過有趣的是, 對於那些已經在 ImageNet 訓練得非常好的模型, 如: VGG-19, 我們通常已經同意模型可以辨別一些較抽象的概念
那麼是否模型裡, 也有具備類似風格和創作的元素呢? 又或者風格在模型裡該怎麼表達?