過去幾年寫了不少量化的筆記, 但都偏演算法與數學. 實際要把模型量化後跑在裝置上, 會發現另一半的問題在「後端」: 哪些 op 有 int8 kernel? 圖會被切成幾段? 切太多使得 NPU 與 CPU 來回切換反而更慢, 精度掉了又該找誰查?
因此整理了一份動手教材, 用 PyTorch 2 Export (PT2E) 把模型量化成 int8, 再交給 ExecuTorch + XNNPACK, ONNX Runtime 這類後端執行. 這篇文章是它的導讀.
- 教材網站 (建議從這裡讀): https://bobondemon.github.io/pt2e_quantize_and_deploy/
- GitHub: https://github.com/bobondemon/pt2e_quantize_and_deploy
動機
如果你需要在 edge 端訓練模型, 量化, 部署模型, 又或者想知道「模型演算法工程師」與「後端部署工程師」兩個角色的分工職責, 這份教材就是為此而寫的.
- 用過 PyTorch 訓練模型, 想把模型量化成 int8 並部署到 CPU 或加速器上的演算法工程師.
- 讀過
torch.ao.quantization時代的文章, 想知道 PT2E 現在怎麼用的人. API 在 torch 2.14 已搬到 torchao, 舊文章的 import 路徑多半失效了. - 負責模型部署, 需要寫或讀 Quantizer 的後端工程師.
不需要量化的背景, 但需要知道 nn.Module 怎麼寫, 怎麼訓練. PT2E 的每一步都在改 torch.fx 的圖, 不熟 fx 的話可以先讀之前寫的 PyTorch FX 的 Graph/Node 一些基礎概念, 教材的 M00 也會用小例子帶過.
以 Q/DQ 圖為界的兩個部分
教材的主軸是 convert_pt2e 產生的 Q/DQ 圖 (fp32 運算, 但用 quantize/dequantize 模擬 int8). 以它為界分成兩個部分:
| 第一部分 (M01~M06) | 第二部分 (M07~M10) | |
|---|---|---|
| 做什麼 | fp32 模型 → PTQ/QAT → Q/DQ 圖 | Q/DQ 圖 → 後端的 int8 kernel → 裝置 |
| 角色 | 演算法人員: 建模, 訓練, 量化 | 後端部署人員: 選定平台, 提供 Quantizer, lowering 與驗證 |
整個故事線如下圖. 注意圖中的虛線是反方向的: Quantizer 是後端照自己的 kernel 設計的, 所以實務上要先選後端, 再量化.
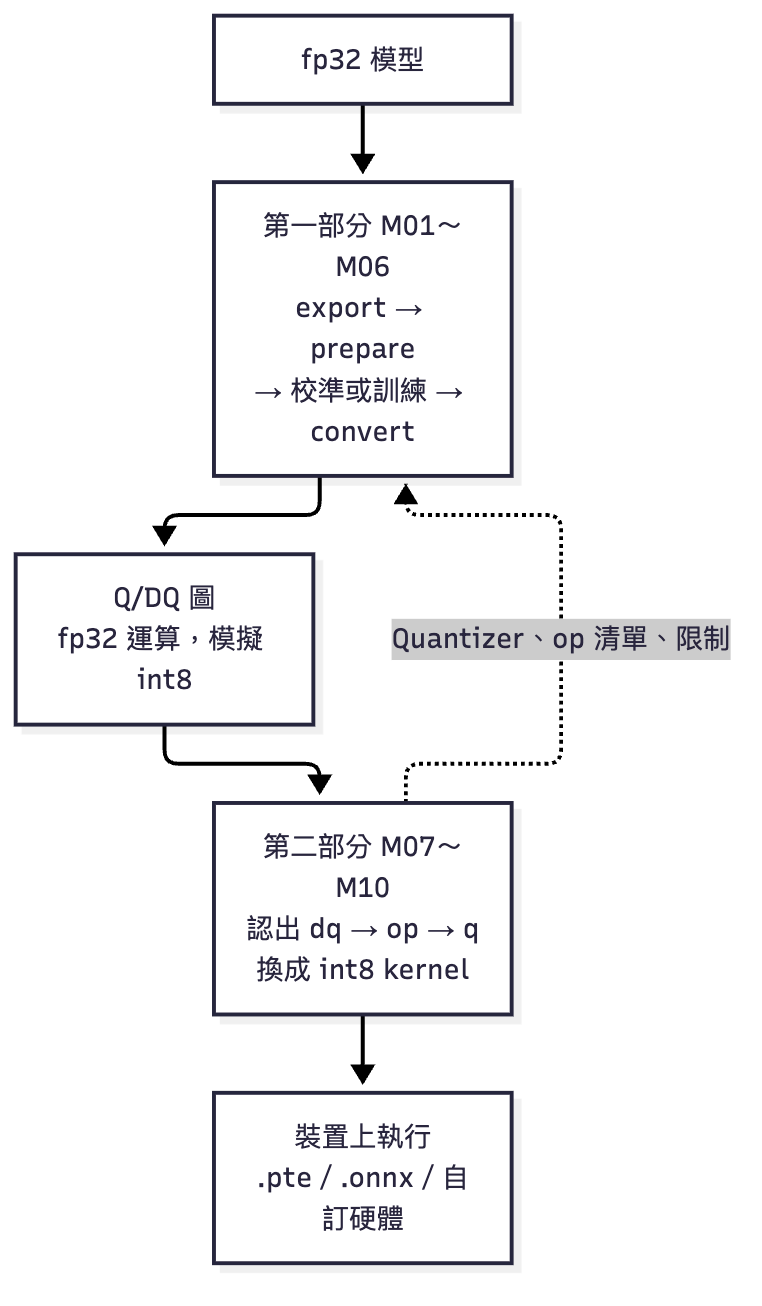
兩種角色如何合作
兩種角色不是各做各的, 合作的順序如下:
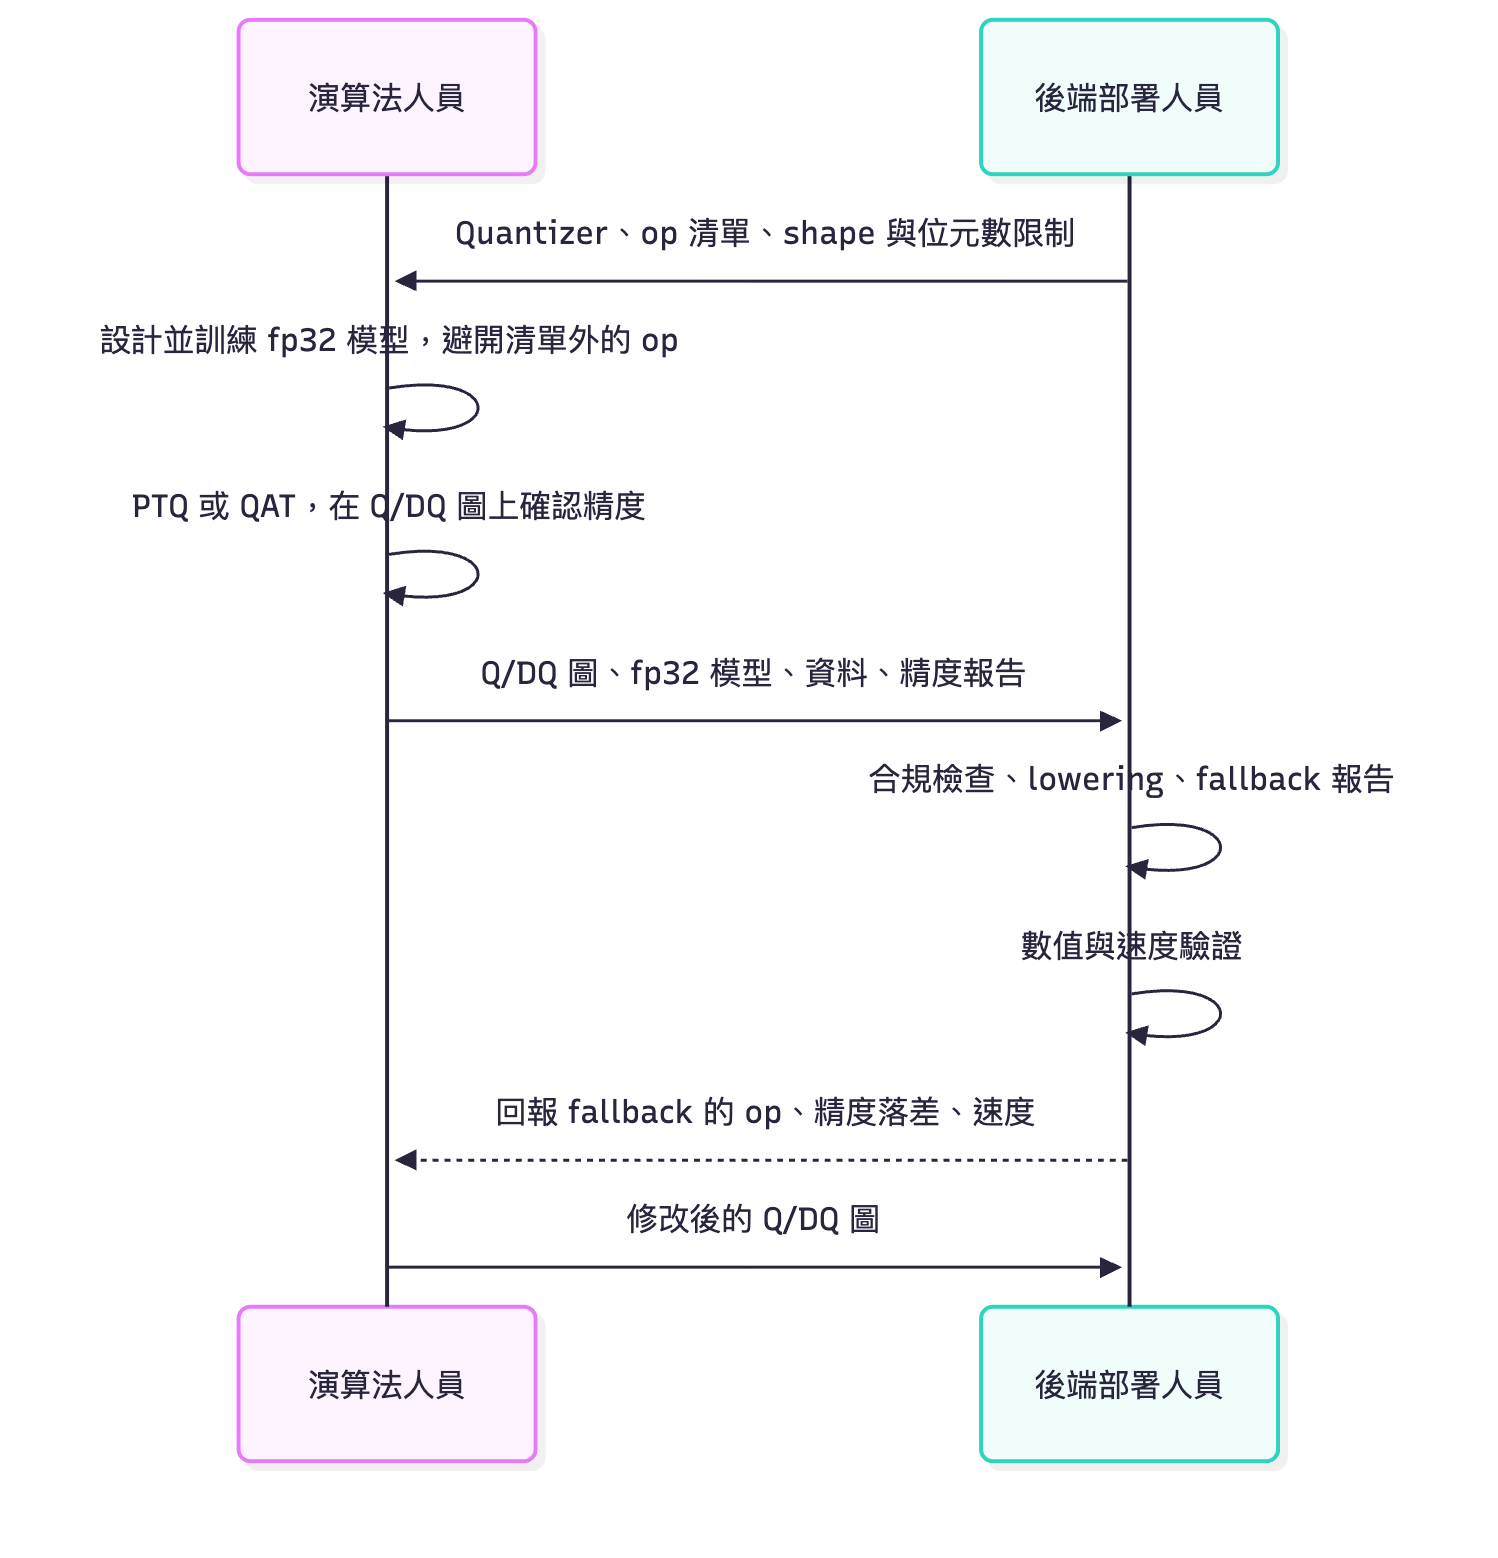
最後兩步通常會來回好幾次.
這兩種角色可能是不同人負責又或是同一人
還是乾脆把角色描述寫清楚讓 Agent 負責??
從以前的 fx symbolic trace 到 PT2E, PyTorch 明確把模型訓練和不同平台部署解耦, 又同時提供 Quantizer 介面讓兩者溝通.
除此之外也把 NN 計算圖從 module 層級攤平成統一個 ATen 層級, 這使得後端看到的計算圖有了一致的溝通語言 (見 為什麼圖上都是 ATen op)
譬如一個 convolution 用 module 來寫有許多不同寫法
但統一用 ATen 則在圖上看到的 node op 一定是torch.ops.aten.conv2d.default
這樣後端很好認
最後歡迎到 GitHub 或網站上看看, 有任何問題或建議也請不吝指教.