import copy

import matplotlib.pyplot as plt
import torch
from matplotlib_inline.backend_inline import set_matplotlib_formats

from common.data import calibration_batches, evaluate, make_loader, trained_tiny_net
from common.graph_utils import qdq_nodes, sqnr
from common.models import example_inputs
from common.pt2e import (
    ANNOTATION_KEY,
    QuantizationAnnotation,
    Quantizer,
    convert_pt2e,
    export_module,
    get_xnnpack_quantizer,
    prepare_pt2e,
    quiet,
)
from common.viz import table

quiet()
_ = torch.manual_seed(0)
set_matplotlib_formats("svg")
BLUE, MUTED = "#2a78d6", "#52514e"M05-4 | Mixed precision:把敏感的層留在 fp32,看精度回升多少

M05-3 的逐層 SQNR 給了線索。這本 notebook 用實驗檢驗線索:實際把某個 module 排除在量化之外,量整體輸出 SQNR 回升多少。
- A. 寫一個「排除某些 module」的 Quantizer,包住 XNNPACKQuantizer。
- B. 逐一排除每個 module,比較整體 SQNR。
- C. 只拿掉
fc的輸出量化,驗證 B 的結果是怎麼來的。 - D. 誤差會累積:只量化前 k 個 module,k 越大整體 SQNR 越低。
A. 排除某些 module 的 Quantizer
SkipQuantizer 先讓裡面的 XNNPACKQuantizer 照常貼標籤,再把指定 module 裡 node 的標籤清掉,這些 node 就留在 fp32(M03-6 的局部量化)。 判斷 node 屬於哪個 module,看它的 node.meta["nn_module_stack"]。
清標籤有一個麻煩:別的 node 的標籤可能是 SharedQuantizationSpec,指向被清掉的 node(M03-4)。不處理的話 prepare_pt2e 會 KeyError。 而且被指向的標籤清掉之後,指向它的標籤也失效,所以要反覆清,直到沒有變化為止。
no_output 是 C 段用的:只拿掉這些 module 的輸出量化,輸入與 weight 仍然量化。
def in_module(node, name):
    """node 是否屬於 module `name`(含子 module)。"""
    stack = node.meta.get("nn_module_stack") or {}
    return any(path == name or path.startswith(name + ".") for path, _ in stack.values())


def shares_with(spec, dead):
    """spec 是不是共用某個已被清掉標籤的 node。"""
    if type(spec).__name__ != "SharedQuantizationSpec":
        return False
    target = spec.edge_or_node
    return (target[0] if isinstance(target, tuple) else target) in dead


class SkipQuantizer(Quantizer):
    def __init__(self, inner, skip=(), no_output=()):
        self.inner, self.skip, self.no_output = inner, tuple(skip), tuple(no_output)

    def annotate(self, model):
        self.inner.annotate(model)
        dead = set()  # 輸出已經不量化的 node
        for n in model.graph.nodes:
            ann = n.meta.get(ANNOTATION_KEY)
            if n.op != "call_function" or ann is None:
                continue
            if any(in_module(n, m) for m in self.skip):
                n.meta[ANNOTATION_KEY] = QuantizationAnnotation(_annotated=True)  # 整個清掉,仍標記為已處理
                dead.add(n)
            elif any(in_module(n, m) for m in self.no_output):
                ann.output_qspec = None
                dead.add(n)
        changed = True
        while changed:  # 共用失效會連鎖:反覆清到沒有變化
            changed = False
            for n in model.graph.nodes:
                ann = n.meta.get(ANNOTATION_KEY)
                if ann is None:
                    continue
                for edge in [e for e, spec in ann.input_qspec_map.items() if shares_with(spec, dead)]:
                    del ann.input_qspec_map[edge]
                    changed = True
                if n not in dead and shares_with(ann.output_qspec, dead):
                    ann.output_qspec = None
                    dead.add(n)
                    changed = True
        return model

    def validate(self, model):
        pass
模型、校準資料、評估資料都和 M05-1 相同:
model = trained_tiny_net()
gm = export_module(model, example_inputs())
test_loader = make_loader(n=1024, seed=2, shuffle=False)
(x,) = next(calibration_batches(64, seed=9))
with torch.no_grad():
    y_ref = model(x)


def quantize(**skip_kwargs):
    prepared = prepare_pt2e(copy.deepcopy(gm), SkipQuantizer(get_xnnpack_quantizer(is_per_channel=True)[0], **skip_kwargs))
    with torch.no_grad():
        for batch in calibration_batches(128):
            prepared(*batch)
    return convert_pt2e(prepared)


def measure(converted):
    with torch.no_grad():
        return sqnr(y_ref, converted(x)), evaluate(converted, test_loader), len(qdq_nodes(converted))


def show(results):
    return table([[k, f"{s:.2f}", f"{a:.4f}", q] for k, (s, a, q) in results.items()],
                 ["設定", "輸出 SQNR (dB)", "accuracy", "q/dq 數"])
B. 逐一排除每個 module
TinyConvNet 的四個子模組依序是 stem、block、head_conv、fc。每次只把其中一個留在 fp32,其餘照常 int8:
MODULES = ("stem", "block", "head_conv", "fc")
b = {"全部 int8": measure(quantize())}
for name in MODULES:
    b[f"{name} 留 fp32"] = measure(quantize(skip=[name]))
show(b)| 設定 | 輸出 SQNR (dB) | accuracy | q/dq 數 |
|---|---|---|---|
| 全部 int8 | 27.35 | 0.7051 | 28 |
| stem 留 fp32 | 27.64 | 0.7100 | 23 |
| block 留 fp32 | 27.09 | 0.7109 | 19 |
| head_conv 留 fp32 | 27.19 | 0.7051 | 23 |
| fc 留 fp32 | 33.03 | 0.7041 | 25 |
base = b["全部 int8"][0]
gain = {name: b[f"{name} 留 fp32"][0] - base for name in MODULES}
best = max(gain, key=lambda k: gain[k])
print("排除後 SQNR 的變化:", {k: f"{v:+.2f} dB" for k, v in gain.items()})
assert best == "fc" and abs(gain["head_conv"]) < 1.0
assert all(b[f"{n} 留 fp32"][2] < b["全部 int8"][2] for n in MODULES)
排除後 SQNR 的變化: {'stem': '+0.29 dB', 'block': '-0.25 dB', 'head_conv': '-0.15 dB', 'fc': '+5.68 dB'}- 排除
fc回升最多;M05-3 逐層表裡掉最多的head_conv,排除之後幾乎沒變。逐層 SQNR 掉得多的位置,不一定是排除它最有用的位置。 - 排除一個 module 後 q/dq 數變少(少量化一層,就少了那一層的量化點),但 fp32 與 int8 的交界仍會有 q/dq(M03-6)。
- accuracy 在這個任務上不敏感(M05-1),差別落在雜訊量級,只有 SQNR 看得出來。
C. 為什麼排除 fc 有效
fc 留 fp32 時,它的輸入、weight、輸出都不量化。只拿掉它的輸出量化(輸入與 weight 仍是 int8)試試:
c = {"全部 int8": b["全部 int8"], "fc 留 fp32(輸入、weight、輸出都不量化)": b["fc 留 fp32"],
     "fc 只拿掉輸出量化(輸入、weight 仍 int8)": measure(quantize(no_output=["fc"]))}
show(c)| 設定 | 輸出 SQNR (dB) | accuracy | q/dq 數 |
|---|---|---|---|
| 全部 int8 | 27.35 | 0.7051 | 28 |
| fc 留 fp32(輸入、weight、輸出都不量化) | 33.03 | 0.7041 | 25 |
| fc 只拿掉輸出量化(輸入、weight 仍 int8) | 33.12 | 0.7051 | 26 |
only_output = c["fc 只拿掉輸出量化(輸入、weight 仍 int8)"][0]
print(f"只拿掉輸出量化:{only_output:.2f} dB;整個 fc 留 fp32:{b['fc 留 fp32'][0]:.2f} dB")
assert abs(only_output - b["fc 留 fp32"][0]) < 0.5
只拿掉輸出量化:33.12 dB;整個 fc 留 fp32:33.03 dB只拿掉 fc 的輸出量化,SQNR 就回升到和「整個 fc 留 fp32」差不多:B 段排除 fc 的好處,幾乎全來自最終輸出(logits)不再被量化。 為什麼這個模型的 logits 對量化這麼敏感,這裡沒有深究(可能和 logits 的值域有關,推論);其他模型是否也如此,沒有驗證。
實務上的經驗確實如此,通常模型頭尾需要保留較高精度效果最好;部落格〈Learning Zero-Point and Scale in Quantization Parameters〉也提到,LSQ 把第一層與最後一層留在 8 bit 已是標準做法。
mixed precision 的流程因此是:整體 SQNR 判斷有沒有問題 → 逐層 SQNR 縮小範圍(M05-3)→ 實驗排除候選確認(本節)→ 在能解決問題的做法裡選動得最少的。 本例最少的是只拿掉 fc 的輸出量化。「動得最少比較便宜」是推論,這裡沒有量測執行成本。
D. 誤差會累積:只量化前 k 個 module
前 k 個 module 量化,其餘留 fp32。k 從 1 到 4:
d = []
for k in range(1, len(MODULES) + 1):
    d.append((" + ".join(MODULES[:k]), measure(quantize(skip=MODULES[k:]))[0]))
畫圖的程式
fig, ax = plt.subplots(figsize=(6.4, 3.2))
ax.plot(range(len(d)), [s for _, s in d], color=BLUE, lw=2, marker="o", ms=6)
for i, (_, s) in enumerate(d):
    below = i == len(d) - 1  # 最後一點在下降線段的末端,標籤放下方才不會壓到線
    ax.annotate(f"{s:.2f}", (i, s), xytext=(0, -16 if below else 8), textcoords="offset points", ha="center",
                color=MUTED, fontsize=9)
ax.set_xticks(range(len(d)), [f"k={k + 1}\n+ {name.split(' + ')[-1]}" for k, (name, _) in enumerate(d)], fontsize=9)
ax.set_xlim(-0.4, len(d) - 0.6)
ax.set_ylim(min(s for _, s in d) - 2, max(s for _, s in d) + 2)
ax.set_ylabel("output SQNR (dB)", color=MUTED)
ax.grid(axis="y", color="#e6e5e1", lw=0.8)
ax.spines[["top", "right"]].set_visible(False)
ax.tick_params(colors=MUTED)
plt.show()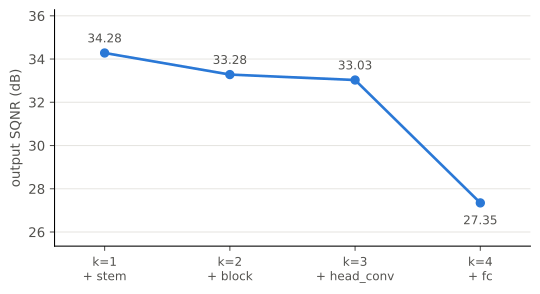
steps = [d[i][1] - d[i - 1][1] for i in range(1, len(d))]
table([[k + 1, name, f"{s:.2f}", "—" if k == 0 else f"{steps[k - 1]:+.2f}"] for k, (name, s) in enumerate(d)],
["k", "int8 的 module", "輸出 SQNR (dB)", "比前一個 row"])| k | int8 的 module | 輸出 SQNR (dB) | 比前一個 row |
|---|---|---|---|
| 1 | stem | 34.28 | — |
| 2 | stem + block | 33.28 | -1.00 |
| 3 | stem + block + head_conv | 33.03 | -0.25 |
| 4 | stem + block + head_conv + fc | 27.35 | -5.68 |
assert all(step < 0 for step in steps)  # 單調下降
assert min(steps) == steps[-1]  # 加入 fc 掉最多
圖的 x 軸標的是第 k 步新加入量化的 module。
- 量化的 module 越多,整體 SQNR 單調下降:量化誤差沿著網路往後累積,這就是 M05-3 看到「越靠近輸出越低」的原因。
- 但每加一個 module 的代價不均勻:加入
fc一次掉得最多(C 段:幾乎全來自 logits 的輸出量化)。在這個模型上,不是每層貢獻差不多的誤差再累加,而是少數位置主導。
誤差確實會累積,但要找問題,得用實驗逐一排除,不能只看逐層分數的趨勢。
小結
- 排除某些 module 的 Quantizer 要處理共用標籤:反覆清到沒有變化。
- 逐層 SQNR 掉最多的位置,排除之後不一定有用;這個模型真正敏感的是 logits 的輸出量化。
- 誤差沿網路累積,但由少數位置主導;先縮小範圍,再用實驗確認。